Huawei avance sa puce Ascend 960 : la Chine construit son IA sans Nvidia
Il y a deux façons de mesurer une puce. On peut comparer ses performances brutes à celles de la concurrence — exercice frustrant tant les chiffres sont partiels. Ou l’on peut regarder le calendrier, qui ne ment jamais. Et c’est là que l’annonce faite par Huawei en septembre 2026 devient intéressante.
Lors de son événement annuel Huawei Connect, à Shanghai, le groupe chinois n’a pas seulement présenté une nouvelle puce : il a avancé son calendrier de trois trimestres. Sa puce phare Ascend 960DT, attendue pour la fin 2027, sera lancée au premier trimestre 2027. Dans une industrie où chaque génération se prépare sur plusieurs années, gagner neuf mois n’est pas un détail de communication : c’est un signal industriel.
Ce que Huawei a réellement annoncé
L’annonce comporte plusieurs volets, et il faut les distinguer.
Le premier concerne le calendrier. Huawei a accéléré sa feuille de route d’accélérateurs d’IA, en dévoilant les spécifications des Ascend 970 et 980 — autrement dit, les deux générations qui suivront la 960. Rendre public ce qui vient après, c’est une manière d’envoyer un message aux acheteurs : la gamme ne s’arrête pas là.
Le deuxième volet est le plus technique, et probablement le plus important. Huawei a présenté un « supernode » Ascend 960 SuperPoD fondé sur une technologie d’optique proche du boîtier (NPO, pour near-packaged optics). L’enjeu n’est pas la puce seule, mais la manière de relier des milliers de puces entre elles. Un modèle d’IA moderne ne tourne pas sur une puce : il tourne sur un essaim de puces qui doivent communiquer à très haute vitesse. Le facteur limitant est souvent le câblage, pas le calcul.
Le troisième volet est celui des interconnexions : UnifiedBus et Hi-ONE. Ce sont les « autoroutes » internes qui relient les puces d’un même supercalculateur. Là encore, la logique est claire : assembler beaucoup de puces de puissance moyenne dans un ensemble très performant est une stratégie plus accessible, quand posséder la puce la plus rapide du monde ne l’est pas.
Pourquoi la connexion entre puces décide de tout
Pour comprendre l’intérêt de cette annonce, il faut renoncer à une idée intuitive : celle de la puce unique qui fait tout. Entraîner un grand modèle d’IA mobile des milliers de processeurs travaillant simultanément sur la même tâche. Chacun doit recevoir sa part de données, calculer, puis renvoyer son résultat aux autres — en permanence, des millions de fois.
Pendant ces échanges, la puce ne calcule pas : elle attend. Le temps perdu en communication peut représenter une part considérable du temps total. C’est pourquoi relier des puces entre elles par la lumière plutôt que par le cuivre électrique change l’équation. Les liaisons optiques transportent davantage d’information, plus vite, avec moins de pertes de chaleur.
En présentant une technologie d’optique proche du boîtier comme une première mondiale dans un supernode, Huawei ne se contente donc pas de rattraper Nvidia sur la puce : il attaque le point où l’échelle se gagne. C’est une stratégie cohérente pour un pays qui ne peut pas acheter les puces les plus avancées, mais qui peut en assembler énormément et les faire communiquer efficacement.
Les restrictions américaines ont-elles fonctionné ?
C’est la question à laquelle il faut répondre sans posture. Depuis plusieurs années, les États-Unis restreignent l’exportation vers la Chine des accélérateurs d’IA les plus avancés, ainsi que des technologies de réseau et des logiciels associés. L’objectif affiché : ralentir la capacité chinoise en intelligence artificielle.
Le résultat est double, et contradictoire. D’un côté, les restrictions ont bien fonctionné sur le terrain visé : la Chine n’a pas accès aux puces les plus performantes, et cet écart ne se referme pas entièrement. C’est une réalité qu’aucune communication d’entreprise ne fait disparaître.
De l’autre, elles ont produit un effet que leurs auteurs n’avaient pas voulu : elles ont rendu le marché chinois urgent. Un client qui ne peut pas acheter à l’étranger devient un client pour la production nationale. Les constructeurs chinois ont obtenu, du jour au lendemain, un marché intérieur protégé, avec des acheteurs — centres de données, opérateurs, laboratoires — qui n’avaient plus d’autre choix.
C’est un schéma connu. Les mêmes restrictions sur les équipements de fabrication de semi-conducteurs ont accéléré les investissements chinois dans ce domaine. Chaque restriction crée une demande solvable pour l’alternative locale, et une alternative qui a des clients finit par progresser.
Le vrai verrou n’est pas le silicium
Il reste cependant un obstacle majeur, et Huawei le connaît mieux que personne : le logiciel. Nvidia n’est pas dominant uniquement grâce à ses puces. Elle l’est parce que des années de travail ont installé son écosystème — CUDA — comme le langage par défaut des développeurs d’IA. Une bibliothèque, des outils, de la documentation, l’habitude : tout un environnement qu’on ne remplace pas en changeant de matériel.
Migrer vers un accélérateur chinois implique de réécrire, d’adapter, de déboguer, et de perdre en performance pendant la transition. C’est faisable à grande échelle — obligatoire, même, quand on n’a pas le choix — mais c’est lent et coûteux. C’est probablement dans cette transition logicielle, plus que dans la finesse de gravure, que se situe le délai réel.
Une publication de l’agence Reuters rapportait en mai 2026 que Huawei affirmait pouvoir fabriquer des semi-conducteurs de premier plan grâce à « une nouvelle technologie, dans cinq ans ». Cinq ans : c’est un horizon honnête pour un tel chantier. Ni triomphalisme, ni résignation.
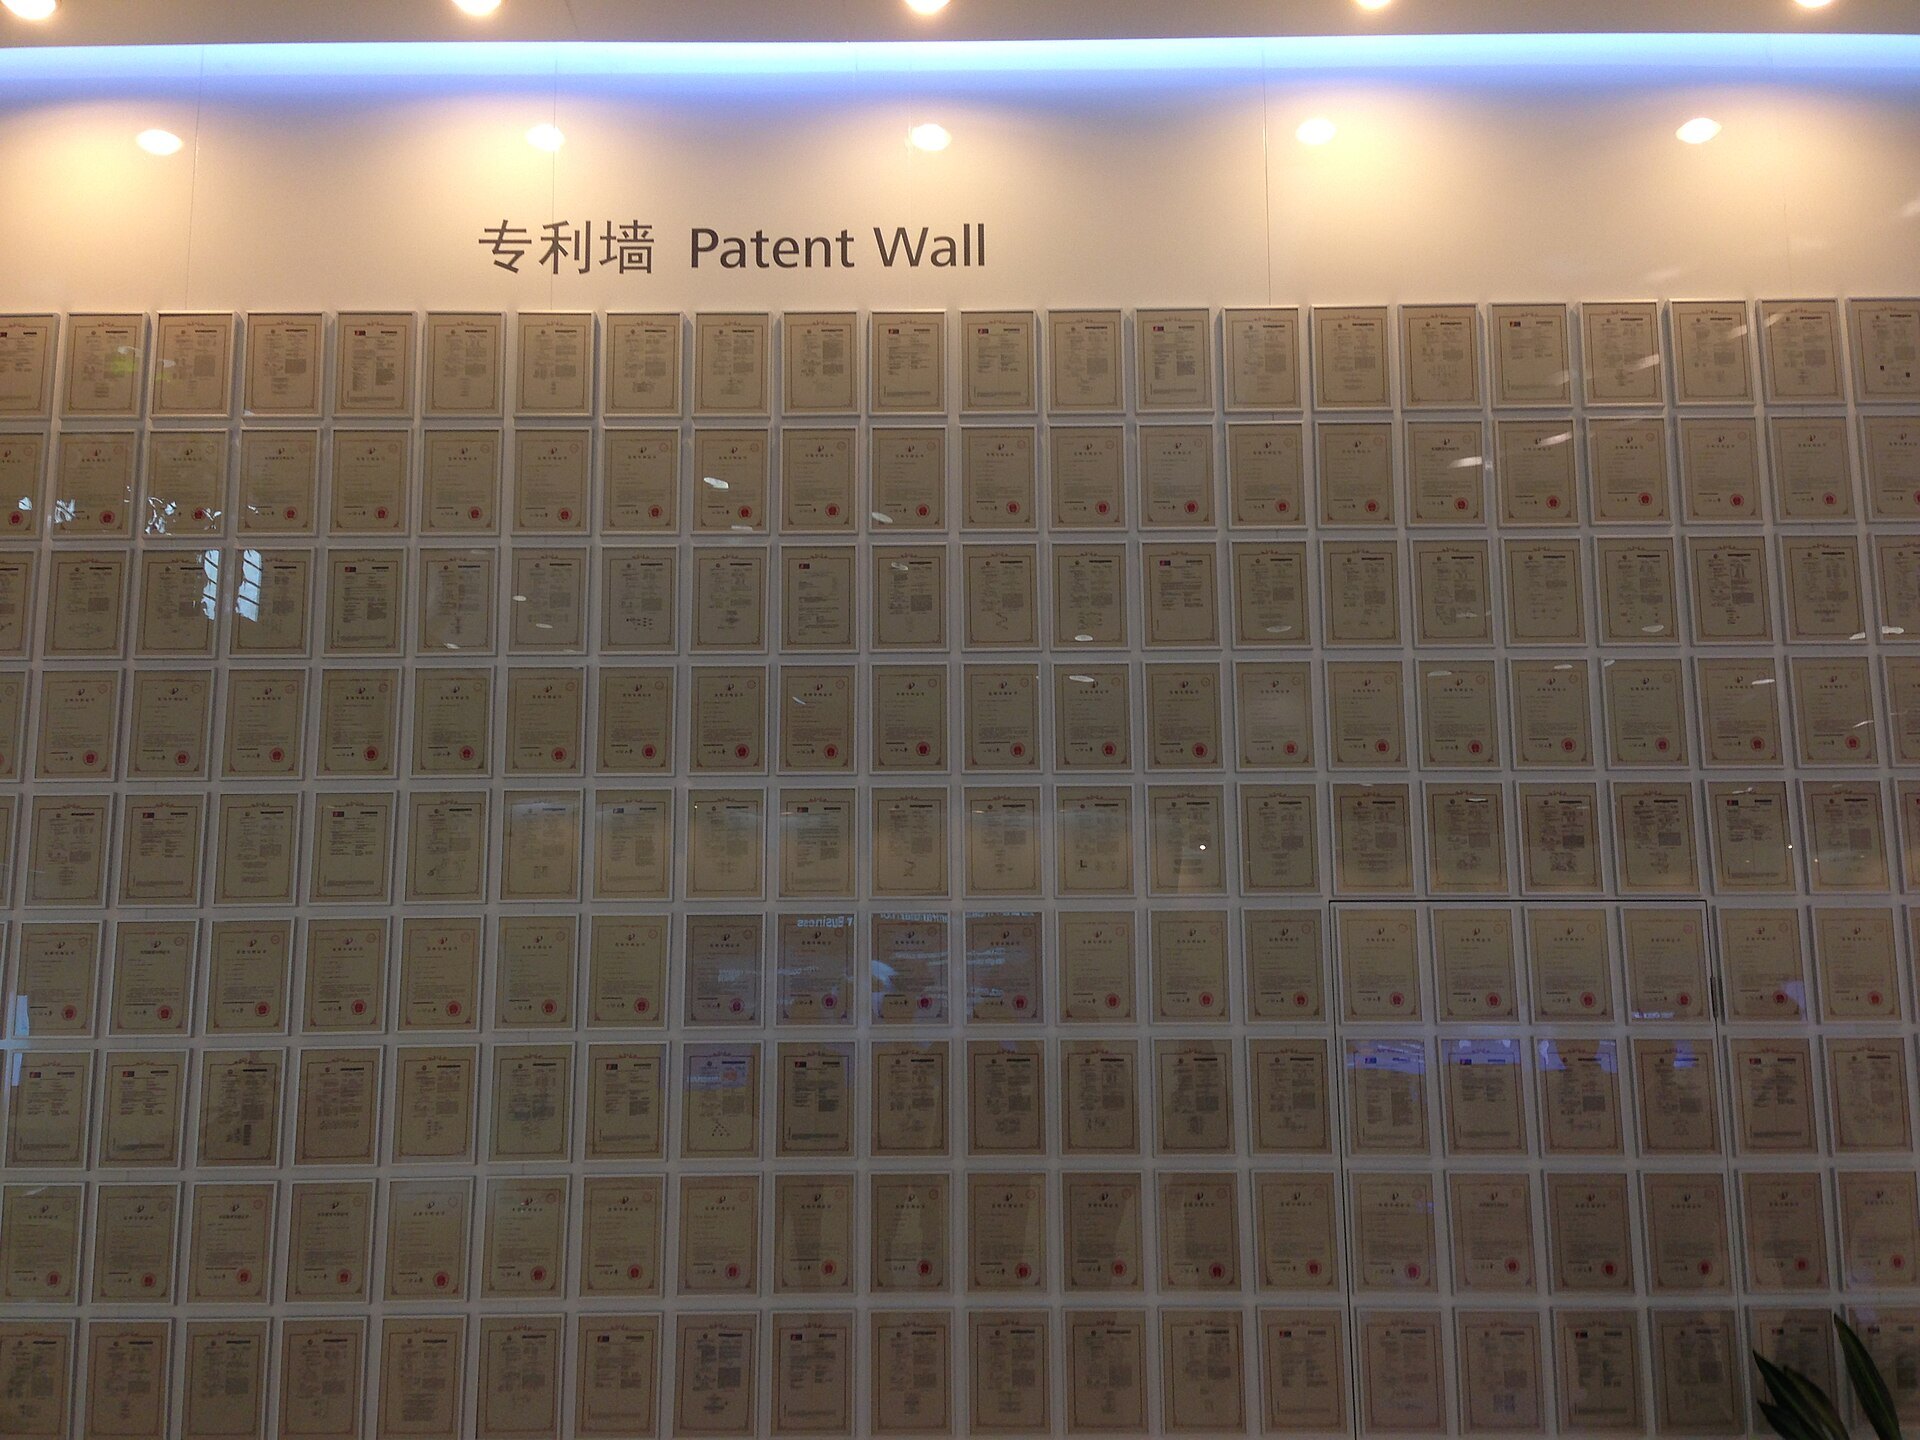
Ce que cela change pour le reste du monde
Trois conséquences méritent d’être posées clairement.
La première concerne les prix. Un second fournisseur crédible sur le marché des accélérateurs d’IA, même légèrement en retrait, pèse sur les tarifs. Nvidia n’a jamais eu à craindre un concurrent capable d’absorber une part significative de la demande mondiale. Si Huawei y parvient, ne serait-ce que sur le marché chinois — le deuxième au monde —, la pression à la baisse se fera sentir bien au-delà.
La deuxième concerne la souveraineté. Le message envoyé aux pays qui dépendent entièrement d’une chaîne d’approvisionnement unique est simple : un pays privé d’accès a construit une alternative en quelques années. Cette démonstration change les calculs de beaucoup de gouvernements, y compris européens.
La troisième est un avertissement. Une course aux accélérateurs entre deux blocs produit un monde fragmenté : deux écosystèmes techniques, deux bibliothèques logicielles, deux façons de faire de l’IA. Pour les entreprises qui doivent choisir, cela signifie des coûts de duplication et une perte d’interopérabilité — c’est-à-dire moins d’efficacité globale.
Ce que l’Europe devrait en retenir
L’Europe se trouve dans une position singulière dans ce dossier : elle a accès aux puces américaines, elle n’a pas de champion comparable à Nvidia ou Huawei, et elle dépend de l’extérieur pour la quasi-totalité de sa puissance de calcul. Ce n’est pas une situation intenable — c’est une situation fragile.
Deux enseignements se dégagent de l’exemple chinois. D’abord, que le volume peut compenser la finesse : assembler beaucoup de puces disponibles dans une architecture intelligente est une voie praticable. Ensuite, que le logiciel est un actif stratégique au même titre que le matériel — un écosystème de développement se construit sur des décennies, et s’il n’existe pas, c’est lui qu’il faut financer.
Le reste relève de la décision politique, et ce n’est pas à une analyse technique de la trancher.
En résumé
Huawei a avancé d’un an son calendrier, présenté trois générations d’accélérateurs, dévoilé un supernode à liaisons optiques et continué d’investir dans ses propres interconnexions. Ce ne sont pas des annonces anodines : chacune répond à une contrainte précise, et ensemble elles dessinent une stratégie cohérente.
Mais aucune de ces annonces ne signifie que la Chine a rattrapé son retard. La puce la plus avancée reste hors de portée, l’écosystème logiciel reste à construire, et l’affirmation d’un semi-conducteur de premier plan est donnée pour un horizon de cinq ans — par l’entreprise elle-même.
La bonne lecture n’est ni l’inquiétude, ni la minimisation. C’est celle-ci : la Chine a transformé une contrainte subie en programme industriel, et neuf mois gagnés sur un calendrier de puce sont le signe que ce programme avance. Savoir à quelle vitesse — voilà la seule question qui compte vraiment.
Sources : DIGITIMES, « Huawei Connect 2026 : Ascend 960 puts industry-first NPO supernode at heart of Huawei’s AI scale-up bet » (17 septembre 2026) ; Pandaily, « Huawei Unveils Ascend 960 SuperPoD With Near-Package Optics at Connect 2026 » (17 septembre 2026) ; Star Market Daily via TrendForce, propos de David Wang, président tournant, sur l’avancement de l’Ascend 960DT ; The Straits Times et Reuters, « Huawei advances AI chip launch to compete with Nvidia » ; Reuters (25 mai 2026), déclarations de Huawei sur une nouvelle technologie de semi-conducteurs à cinq ans ; Tom’s Hardware, « Huawei details AI accelerator roadmap » ; Huawei Central, « Huawei unveils Ascend 960 SuperPoD computing cluster, targeting Nvidia ».
Cet article vous a plu ?
Temps de lecture : environ 10 min
📚 À lire aussi sur IAforAll
Pourquoi le matériel coûte plus cher à La Réunion : l’octroi de mer expliqué sans caricature
19 septembre 2026
IA open source : les quatre meilleurs modèles ouverts du monde sont chinois
19 septembre 2026
Robotaxis : la Chine exporte ses voitures sans conducteur, l’Europe ouvre la porte
19 septembre 2026